Lewati ke konten mikrositus Qlik

LAYANAN QLIK OPEN LAKEHOUSE

Bangun Apache Iceberg Lakehouse yang Terbuka dan Terkelola

Menciptakan fondasi data yang skalabel yang menggabungkan penyerapan real-time, format tabel terbuka, optimasi berkelanjutan, dan akses terkelola untuk analitik dan AI.

Artha membantu perusahaan mengubah Qlik Open Lakehouse menjadi arsitektur data operasional, bukan proyek penyimpanan yang terisolasi.

Lihat Arsitektur Referensi
  • Kapabilitas Qlik Talend Cloud
  • Tabel Apache Iceberg
  • Lingkungan AWS pelanggan
  • Amazon S3 dan AWS Glue

IKHTISAR AI

Bangun Apache Iceberg Lakehouse yang Terbuka dan Terkelola

Artha Solutions merancang dan mengimplementasikan Qlik Open Lakehouse, kapabilitas yang dikelola sepenuhnya berbasis Apache Iceberg di dalam Qlik Talend Cloud. Implementasi saat ini berjalan di lingkungan AWS milik pelanggan menggunakan Amazon S3 dan AWS Glue, dengan akses terkelola untuk analitik yang kompatibel dan mesin AI.

Artha SolutionsQlikQlik Talend CloudTalendKain Data TalendKatalog Data TalendApache IcebergQlik Open LakehouseQlik AnswersQlik PredictQlik AutomateDatabricksSnowflakeB’etl

Apa itu Qlik Open Lakehouse?

Qlik Open Lakehouse adalah kapabilitas berbasis Apache Iceberg yang sepenuhnya dikelola di dalam Qlik Talend Cloud. Ini mendukung ingestion, transformasi, optimasi, and tata kelola data Iceberg di lingkungan AWS milik pelanggan.

Artha merancang model domain pendukung, keamanan, kualitas, observabilitas, akses kueri, dan kepemilikan operasional yang diperlukan agar kapabilitas tersebut siap produksi.

Mengapa Perusahaan Mempertimbangkan Open Lakehouse

Biaya dan kekakuan data warehouse

Harga warehouse mengasumsikan bahwa data memberikan nilai bisnis yang sepadan. Riwayat transaksi imutabel selama tujuh tahun, klik stream mentah, dan telemetri IoT jarang memenuhi asumsi ini: data tersebut jarang dikueri, tetapi harus disimpan dan mendominasi volume penyimpanan. Menyimpannya sebagai tabel Iceberg pada Amazon S3 memisahkan biaya penyimpanan tersebut dari komputasi kueri, sehingga retensi data tidak lagi bersaing dengan performa dalam memperebutkan anggaran yang sama.

Salinan data berulang

Pola yang lazim adalah satu salinan per konsumen, karena setiap engine memerlukan formatnya sendiri. Setiap salinan merupakan pekerjaan yang harus dijadwalkan, rekonsiliasi yang harus dijelaskan, dan versi kebenaran yang lain. Iceberg dibaca secara native oleh Athena, Spark, Trino, dan Snowflake, sehingga tabel yang dikelola tata kelolanya dapat melayani beberapa engine tanpa perlu diduplikasi untuk masing-masing engine tersebut.

Fragmentasi pipeline

Proses ingesti di satu alat, transformasi di alat kedua, pemeriksaan kualitas di alat ketiga, dan katalogisasi yang dilakukan secara manual adalah akar penyebab terputusnya garis keturunan data (lineage). Tidak seorang pun dapat menjawab apa yang berubah di hulu dari suatu angka yang salah, sehingga insiden akhirnya didiagnosis dengan membaca kode secara manual. Mengonsolidasikan perpindahan, transformasi, dan tata kelola di balik satu control plane menjadikan hal tersebut dapat dilacak dengan mudah alih-alih seperti meneliti artefak arkeologi.

Permintaan AI dan analitik

Pelatihan model memerlukan riwayat penuh dan ketepatan titik waktu (point-in-time correctness), bukan tampilan kondisi terkini teragregasi yang menjadi dasar operasional BI. Snapshot Iceberg membuat set pelatihan dapat direproduksi: kueri yang sama terhadap ID snapshot yang sama menghasilkan baris yang sama beberapa bulan kemudian, yang mengubah hasil model menjadi sesuatu yang dapat diaudit.

Operasi Iceberg

Iceberg tidak bebas pemeliharaan. Penulisan kecil yang sering meninggalkan ribuan file data kecil yang memperlambat pemindaian, snapshot yang kedaluwarsa menempati penyimpanan yang tidak lagi direferensikan, dan penulisan yang gagal meninggalkan file yatim piatu. Pemadatan, kedaluwarsa snapshot, dan pembersihan file yatim piatu harus dijalankan sesuai jadwal yang disetel untuk setiap tabel'pola penulisan, atau waktu kueri dan pengeluaran S3 yang sama-sama meningkat ke atas.

Apa yang Diimplementasikan oleh Artha Solutions

Arsitektur dan fondasi

Inventaris workload dinilai berdasarkan volume, kebutuhan kebaruan (freshness), dan pola kueri, kemudian fondasi AWS di bawahnya: tata letak VPC dan subnet, struktur bucket dan prefiks S3, enkripsi KMS, serta peran IAM yang memisahkan platform'akses tulis dari setiap mesin konsumen'akses baca. Keputusan penamaan dan tata letak kini murah dan mahal untuk ditinjau kembali setelah tabel membawa riwayat.

Pemindahan data

Desain ingestion per-sumber dan bukan satu desain default. CDC log transaksi di mana database sumber mendukungnya dan target memerlukan latensi rendah, batch terjadwal di mana jendela harian benar-benar mencukupi, dan streaming dari Kafka atau Kinesis di mana peristiwa tiba secara terus-menerus. Setiap jalur ditentukan dengan pola landing-nya, perkiraan ukuran file, dan kadens kompaksi yang mengikutinya.

Desain tabel Iceberg

Batas domain dirancang sedemikian rupa sehingga setiap tabel memiliki satu pemilik tunggal, partisi dipilih berdasarkan kueri yang benar-benar akan dijalankan alih-alih berdasarkan kebiasaan tanggal ingesti, serta pendaftaran katalog Glue dilakukan dengan tanggung jawab yang jelas untuk perubahan skema. Evolusi partisi berarti pilihan awal masih dapat diperbaiki, namun kesalahan pemilihan tetap memerlukan penulisan ulang (rewrite), sehingga hal ini diselesaikan terlebih dahulu bersama tim konsumen data.

Kontrol kepercayaan

Aturan kualitas dengan ambang batas dan pemilik yang ditentukan untuk setiap produk data, garis keturunan (lineage) yang dicatat dari sumber hingga mesin konsumen, klasifikasi dan masking untuk bidang yang diatur, serta kebijakan akses yang dinyatakan sekali dan diberlakukan secara konsisten di berbagai mesin. Kontrol dijalankan di dalam pipeline untuk menghentikan data yang buruk, bukan pada laporan yang menjelaskannya setelah kejadian.

Konsumsi dan operasional

Pengujian integrasi engine terhadap kombinasi kueri yang nyata, pemantauan pada aspek freshness, kesehatan tabel, jumlah file, dan kegagalan penulisan, alokasi biaya S3 dan komputasi kembali ke beban kerja yang menghasilkannya, serta runbook yang merinci pihak yang bertanggung jawab untuk merespons setiap peringatan. Serah terima dilakukan kepada tim yang telah berpengalaman menangani insiden secara langsung, bukan sekadar menyerahkan dokumentasi.

Arsitektur Referensi Qlik Open Lakehouse

01

Sumber

Database · SAP · Mainframe · SaaS · Kafka · Kinesis · S3

02

Jalur ingesti

Batch · CDC · Streaming

03

Fondasi AWS

VPC Pelanggan · Amazon S3 · Komputasi lakehouse terkelola

04

Open tables

Apache Iceberg · Katalog AWS Glue · Optimasi dan pemeliharaan

05

Konsumen

Amazon Athena · Apache Spark · Trino · Snowflake · SageMaker · Qlik Cloud Analytics

Kontrol horizontalKualitasTata KelolaSilsilahKeamananObservabilitasFinOps

Apa itu Apache Iceberg?

Apache Iceberg adalah format tabel terbuka untuk dataset analitik berskala besar. Alih-alih memperlakukan tabel sebagai sekumpulan file yang berada di dalam folder penyimpanan, Iceberg mempertahankan lapisan metadata yang mencatat secara persis file mana saja yang menjadi bagian dari tabel pada setiap titik waktu. Perubahan tunggal itulah yang membuat hal-hal lainnya menjadi mungkin.

  • Konsistensi transaksional, sehingga pembaca tidak pernah melihat penulisan yang setengah selesai dan dua penulis tidak dapat saling menimpa secara diam-diam
  • Evolusi skema yang menambahkan, mengganti nama, atau menghapus kolom tanpa menulis ulang file data yang ada.
  • Evolusi partisi, sehingga pilihan partisi yang dibuat setahun lalu dapat diubah untuk data baru tanpa membatalkan riwayat
  • Time travel dan rollback terhadap ID snapshot, yang membuat kueri dapat direproduksi dan pemuatan yang buruk dapat dibatalkan.
  • Interoperabilitas mesin, karena format ditentukan secara terbuka alih-alih dimiliki oleh satu vendor.

Bersama-sama, teknologi ini menghadirkan keandalan seperti data warehouse pada data yang disimpan di open object storage. Hal yang tidak dihadirkan adalah pemeliharaan tabel, kepemilikan, atau tata kelola, yang merupakan pekerjaan yang menentukan apakah sebuah lakehouse tetap dapat digunakan pada tahun kedua operasionalnya.

Keputusan Arsitektur yang Dibantu Artha untuk Diselesaikan

Penempatan beban kerja

Beban kerja mana yang harus dipindah dan mana yang harus tetap di tempatnya. Dasbor konkurensi tinggi dengan ekspektasi respons dalam hitungan detik biasanya harus berada di tempat asalnya; pemindaian historis berskala besar, data kejadian mentah (raw event data), dan penyiapan fitur ML adalah kandidat kuat. Pemisahan berdasarkan prinsip tersebut merupakan arsitektur yang disengaja, bukan keraguan.

Kebaruan dan penyerapan data

Apa yang sebenarnya dibutuhkan oleh setiap konsumen, dinyatakan dalam bentuk angka. Penelusuran data secara streaming (streaming ingestion) memerlukan biaya operasional yang lebih tinggi dan menghasilkan lebih banyak file kecil yang harus dipadatkan (compact), sehingga layak digunakan jika faktor menit sangat krusial, dan menjadi pemborosan jika proses bisnis hanya berjalan sekali sehari. Keputusan ini menentukan desain alur kerja (pipeline) sekaligus biaya operasional.

Desain tabel dan katalog

Batasan domain, kunci partisi (partition keys), dan siapa yang memiliki perubahan skema. Iceberg memungkinkan kolom ditambahkan dan partisi berkembang tanpa menulis ulang riwayat, yang menghilangkan kekhawatiran dari perubahan skema, namun hal itu tidak memutuskan siapa yang diizinkan untuk membuat perubahan atau siapa yang diberi tahu ketika perubahan itu terjadi.

Tata kelola dan akses

Satu klasifikasi dan satu set aturan kualitas, yang diterapkan dengan cara yang sama terlepas dari mesin mana yang membaca tabel tersebut. Ketika Athena, Spark, dan Snowflake masing-masing membawa model izin mereka sendiri, akses efektif adalah apa pun yang diizinkan oleh model yang paling longgar, dan tidak seorang pun dapat menyatakan apa model tersebut.

Biaya dan operasional

Tempat biaya terakumulasi dan siapa yang memantaunya. Penyimpanan S3 adalah garis yang terlihat, tetapi volume permintaan dari pemindaian skala besar, komputasi kompak, dan snapshot yang belum kedaluwarsa biasanya adalah hal-hal yang tumbuh secara senyap. Biaya diatribusikan per beban kerja sehingga tim yang menghasilkan biaya tersebut dapat melihatnya.

Penilaian Kesiapan Open Lakehouse

Penilaian kesiapan menghasilkan inventaris beban kerja, kartu skor arsitektur, kasus penggunaan yang diprioritaskan, dan diagram kondisi target.

  • Asumsi biaya dan risiko
  • Ketergantungan fondasi AWS
  • Keputusan katalog dan tata kelola
  • Pola kueri dan konsumsi
  • Peta jalan fondasi 90 hari yang praktis

BUKTI KEBERHASILAN KLIEN

Pengalaman Implementasi yang Berakar pada Hasil Nyata Enterprise

Dipilih dari sistem studi kasus Artha yang telah dipublikasikan. Anonimisasi pelanggan tetap terjaga.

Manufaktur

Analisis Logistik Real-Time dan Modernisasi ETL

Tantangan: Peristiwa inventaris dan logistik membutuhkan waktu lebih dari 24 hari untuk mencapai pelaporan eksekutif, yang membatasi visibilitas pesanan prioritas dan meningkatkan intervensi operasional.

Solusi Artha: Artha mengimplementasikan penangkapan data perubahan Qlik Replicate, pemodelan Qlik Compose, dan alur analitik cloud yang terkelola.

Qlik Cloud, Qlik Replicate, Qlik Compose, Snowflake, Microsoft Azure, Azure, Qlik

<2 menitLatensi data logistik yang dipublikasikan setelah modernisasi
Baca studi kasus
Kesehatan & Ilmu Hayati

Talend dan DIF yang dapat diskalakan untuk 100+ Kumpulan Data Layanan Kesehatan TB

Tantangan: Penyedia analitik layanan kesehatan perlu menyerap dan mengelola lebih dari 100 TB beragam data sekaligus meningkatkan akses dan performa pemrosesan.

Solusi Artha: Artha menerapkan Talend dengan Dynamic Ingestion Framework di atas AWS dan Snowflake, menambahkan validasi otomatis dan pemrosesan yang dapat disesuaikan skalanya.

Talend, AWS, Snowflake, Tableau

50%Pengurangan waktu pemrosesan data yang dipublikasikan
Baca studi kasus
SUMBER DAYA TERKAIT

Lanjutkan Diskusi Arsitektur

Whitepaper

AI dan Modernisasi Data: Kesiapan Perusahaan dan Realisasi Nilai

KONEKSI ANALIS Disponsori oleh: Qlik dan Artha Solutions AI and Data Modernization: Enterprise Readiness and Value Realization Desember 2025 Pertanyaan diajukan oleh: Qlik dan Artha Solutions Jawaban oleh: Stewart Bond.

Jelajahi whitepaper
Whitepaper

Landasan Data Siap Masa Depan: Dari Percontohan AI hingga Nilai Produksi

Keberhasilan dengan AI dimulai dari data. Meningkatkan kualitas dan aksesibilitas data untuk AI adalah prioritas utama organisasi saat ini; sembilan bulan lalu, prioritas tersebut adalah meningkatkan infrastruktur AI. Namun, membangun fondasi data yang solid untuk...

Jelajahi whitepaper
Artikel

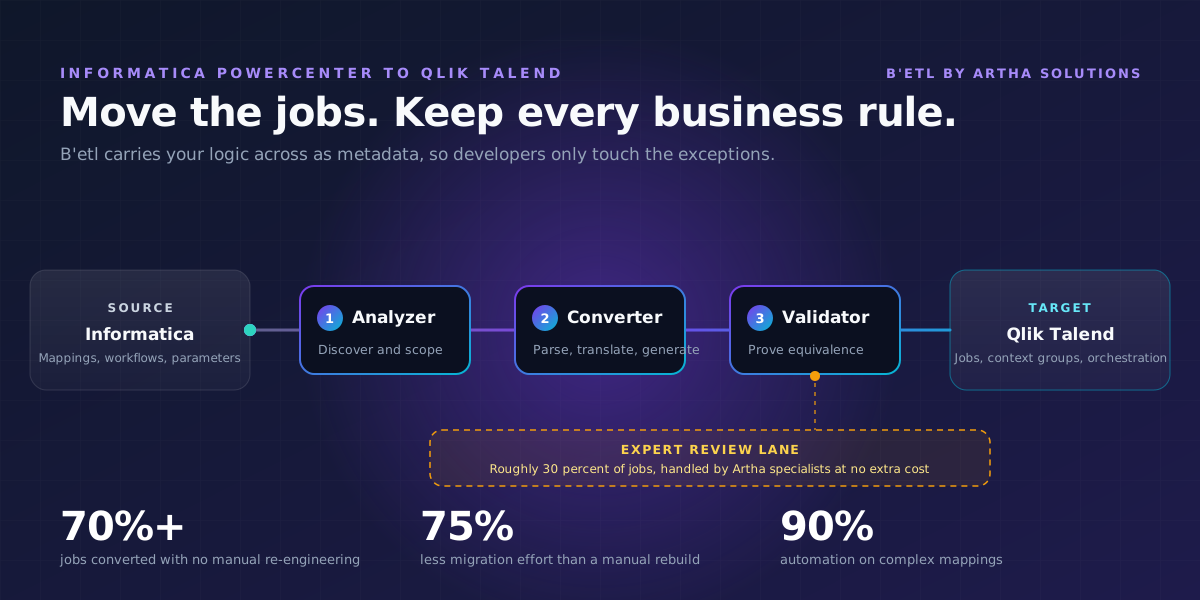
Jauh Lebih Mudah untuk Bermigrasi dari Informatica ke Qlik Daripada yang Anda Pikirkan

Dalam dunia yang digerakkan oleh data saat ini, tetap relevan di masa depan seringkali berarti meninggalkan platform ETL legacy seperti Informatica PowerCenter, terutama saat platform tersebut mendekati akhir dukungan (end-of-support). Meskipun migrasi semacam itu sering dianggap...'etl removes both problems by carrying Informatica business logic across to Talend as metadata, so more than 70 percent of jobs convert with nobody retyping a rule.

Jelajahi artikel

PERTANYAAN YANG SERING DIAJUKAN

Pertanyaan yang Diajukan Pembeli dan Arsitek

Jawaban ringkas berdasarkan informasi produk Qlik saat ini dan pendekatan konsultan Artha.

Apa itu Qlik Open Lakehouse?

Qlik Open Lakehouse adalah kapabilitas berbasis Apache Iceberg yang sepenuhnya dikelola di dalam Qlik Talend Cloud. Solusi ini membantu menyerap (ingest), mengubah, mengoptimalkan, dan mengelola tabel Iceberg di lingkungan AWS pelanggan agar dapat diakses oleh mesin analitik dan AI yang kompatibel.

Apakah Qlik Open Lakehouse berbasis Apache Iceberg?

Ya. Qlik Open Lakehouse menggunakan Apache Iceberg sebagai format tabel terbuka. Dokumentasi Qlik saat ini menjelaskan penerapan di lingkungan AWS pelanggan dengan penyimpanan Amazon S3 dan AWS Glue sebagai katalog.

Mengapa menggunakan Apache Iceberg alih-alih tabel proprietary?

Iceberg menyediakan spesifikasi terbuka, konsistensi transaksional, evolusi skema dan partisi, time travel, serta akses dari mesin yang kompatibel. Hal ini dapat mengurangi keterikatan arsitektural (architectural lock-in), namun tim tetap harus mengambil keputusan yang matang terkait katalog, tata kelola, keamanan, dan operasional.

Apakah lakehouse terbuka menggantikan data warehouse?

Tidak selalu. Lakehouse dapat melengkapi atau menggantikan beban kerja warehouse tertentu tergantung pada latensi, performa, tata kelola, keahlian, dan aspek ekonomi. Artha mengevaluasi beban kerja secara individual alih-alih berasumsi satu tujuan untuk setiap dataset.

Bagaimana data masuk ke Qlik Open Lakehouse?

Sumber data yang didukung dapat di-onboard menggunakan Qlik data movement dengan jalur batch, change data capture, dan streaming yang didukung. Data diproses menjadi tabel Iceberg yang siap kueri di lingkungan AWS yang telah dikonfigurasi.

Mesin analytics apa saja yang dapat mengakses tabel Iceberg?

Engine kompatibel yang didokumentasikan oleh Qlik meliputi Amazon Athena, Apache Spark, Trino, Snowflake, dan alur kerja yang berkaitan dengan Amazon SageMaker. Integrasi dan ketersediaan yang pasti harus dikonfirmasi untuk langganan Qlik dan wilayah pelanggan selama tahap perancangan arsitektur.

Bagaimana Artha menerapkan tata kelola?

Artha mendefinisikan kepemilikan data, klasifikasi, aturan kualitas, lineage, tanggung jawab katalog, kebijakan akses, retensi, dan proses pengecualian. Tata kelola diimplementasikan sebagai kontrol operasional horizontal alih-alih sebagai langkah pelaporan akhir.

Beban kerja apa yang harus dipindahkan terlebih dahulu?

Kandidat prioritas awal memiliki nilai bisnis yang jelas, karakteristik sumber data yang dapat dipahami, batasan kebaruan atau biaya yang terukur, pemilik yang akuntabel, serta kebutuhan tata kelola yang terkelola dengan baik. Asesmen kesiapan memetakan kandidat-kandidat ini terhadap kompleksitas, risiko, dan kesesuaian arsitektur.

LANGKAH BERIKUTNYA

Nilai Peluang Open Lakehouse Anda

Prioritaskan beban kerja yang tepat dan tetapkan asumsi AWS, katalog, tata kelola, dan operasional sebelum implementasi.

DISKUSI ARSITEKTUR

Berbicara dengan Arsitek Qlik

Ceritakan kepada kami tentang platform, beban kerja, dan prioritas bisnis yang sedang Anda evaluasi.